
What it is
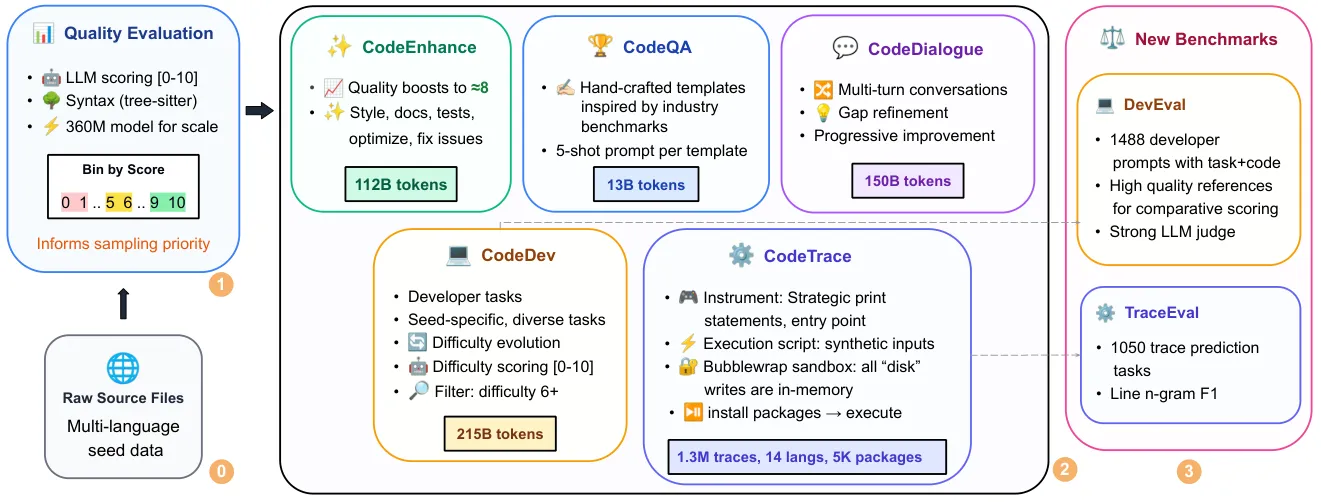
Synthetic code corpus for training and evaluating code LMs, spanning rewriting, QA, dev tasks, dialogue, and execution traces at near-trillion-token scale. ~162M rows and ~976.6B tokens across 5 training subsets and 2 eval sets: code rewriting, code QA, developer tasks, multi-turn dialogue, and execution traces in Parquet.
Key results
- 162,417,042 rows total across 7 subsets
- ~976.6B estimated tokens in Parquet files
- 5 train subsets + 2 test/eval subsets
Useful for pretraining and benchmarking code models on generation, reasoning, dialogue, and trace prediction.