
What it is
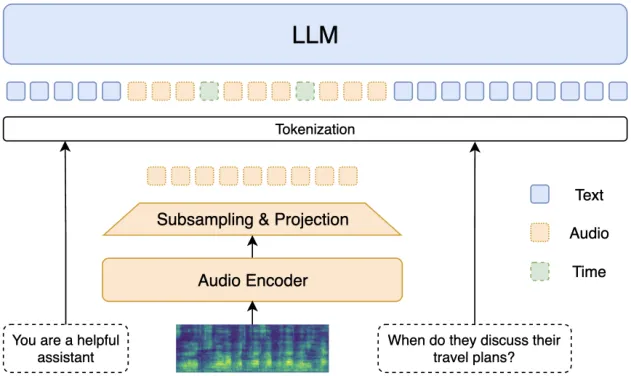
Synthetic English long-audio dataset for timestamped speech QA and summarization across localization, interval description, and timed summaries. ~63k English long-form recordings totaling ~14.2k hours, with 3 time-grounded annotation views: temporal localization, temporal description, and segmented timestamped summaries.
Key results
- 59k train + 4.2k test recordings
- 13.0k train hours + 1.2k test hours
- 4 duration buckets from 0-10 to 60-120 min
Useful for training and evaluating long-audio timestamp localization, interval description, and timed summarization models.